2026-10-10 · Fuente:Unite AI
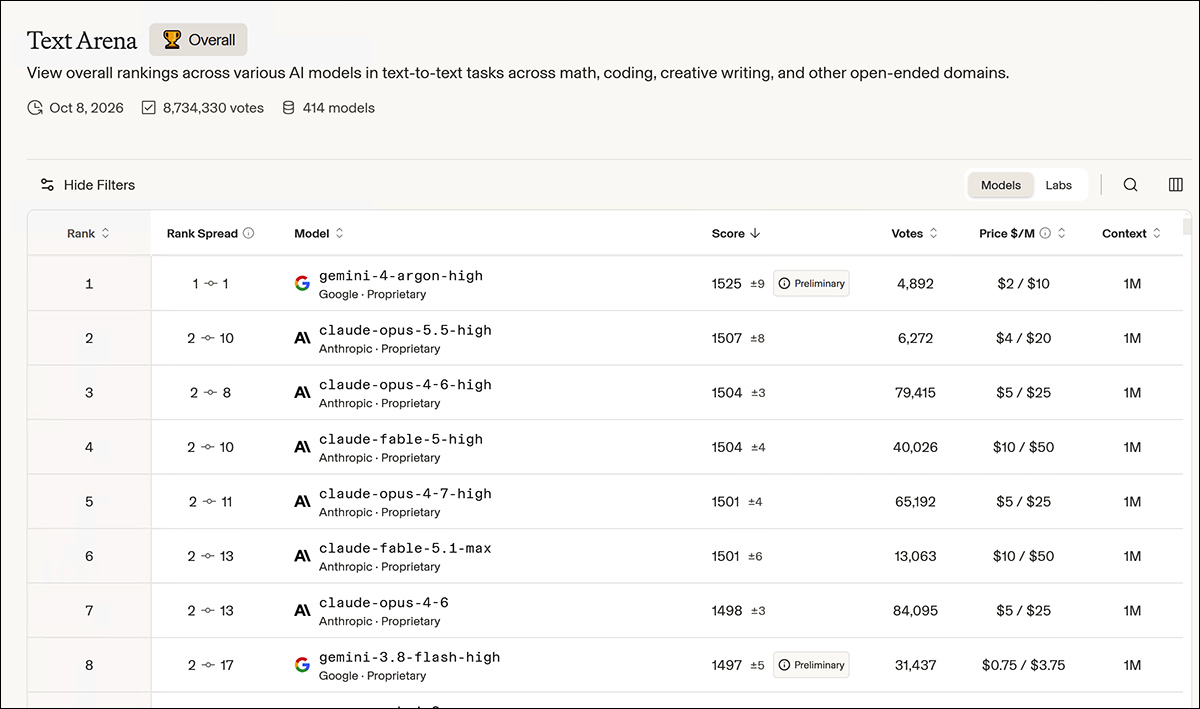
Prompts, configuraciones y datasets idénticos deberían garantizar una comparación justa — sin embargo, señales temporales ocultas en los prompts de sistema pueden colarse a través de ese montaje controlado.
En algún punto de la fontanería de una ejecución de benchmark hay una variable que nadie controló: una fecha, guardada en un prompt de sistema, que dirige los resultados en silencio.
Los benchmarks son la estructura de carga del mercado de los grandes modelos de lenguaje. Sin ellos, los consumidores y las empresas no tienen una forma fiable de juzgar qué progreso ha hecho realmente un modelo entre versiones, o cómo se mide frente a los competidores. Las decisiones de compra, las actualizaciones y el posicionamiento competitivo se apoyan todos en puntuaciones que se presumen comparables — y eso es exactamente por lo que las grietas en la metodología de evaluación importan mucho más allá de la comunidad investigadora.
La dificultad central viene de serie en la tecnología. Los grandes modelos de lenguaje son no deterministas: alimentados con la misma entrada, no siempre producen salidas consistentes. Los datasets y las configuraciones de benchmark idénticos pueden por tanto arrojar puntuaciones distintas entre ejecuciones, y cierto grado de varianza se acepta desde hace tiempo como el costo de medir estos sistemas siquiera.
La defensa estándar es el control exhaustivo — prompts idénticos, configuraciones de modelo idénticas, datasets de benchmark idénticos — de modo que cualquier brecha restante en las puntuaciones pueda atribuirse al propio modelo. Pero como destaca el reportaje de Unite AI, diferencias aparentemente menores del entorno de ejecución pueden persistir incluso bajo esa disciplina. Las fechas secretas incrustadas en los prompts de sistema son el ejemplo que lo demuestra: una variable que sobrevive a la lista de verificación estándar porque se esconde dentro de uno de los mismos artefactos que los investigadores creen tener bien fijados.
El resultado es un benchmark cuyos números parecen limpios y no lo son.
Para los compradores e inversores de cómputo de IA, la consecuencia práctica es una recalibración de la confianza. Las afirmaciones de progreso versión sobre versión y las comparaciones directas entre competidores son solo tan sólidas como el montaje de evaluación que tienen detrás, y ese montaje — resulta ahora — puede socavarse en silencio con algo tan banal como una cadena de fecha en un prompt. Hasta que las cadenas de evaluación tengan en cuenta las señales temporales ocultas, los números de los benchmarks deben tratarse como señales orientativas y no como verdad absoluta.
Etiquetas: LLM Benchmarks · System Prompts · Model Evaluation · Non-Determinism · Large Language Models
萬安算交所 AIXX · AIXX · Exchange verificado · Ir al mercado