2026-11-03 · Fuente:虎嗅·中继
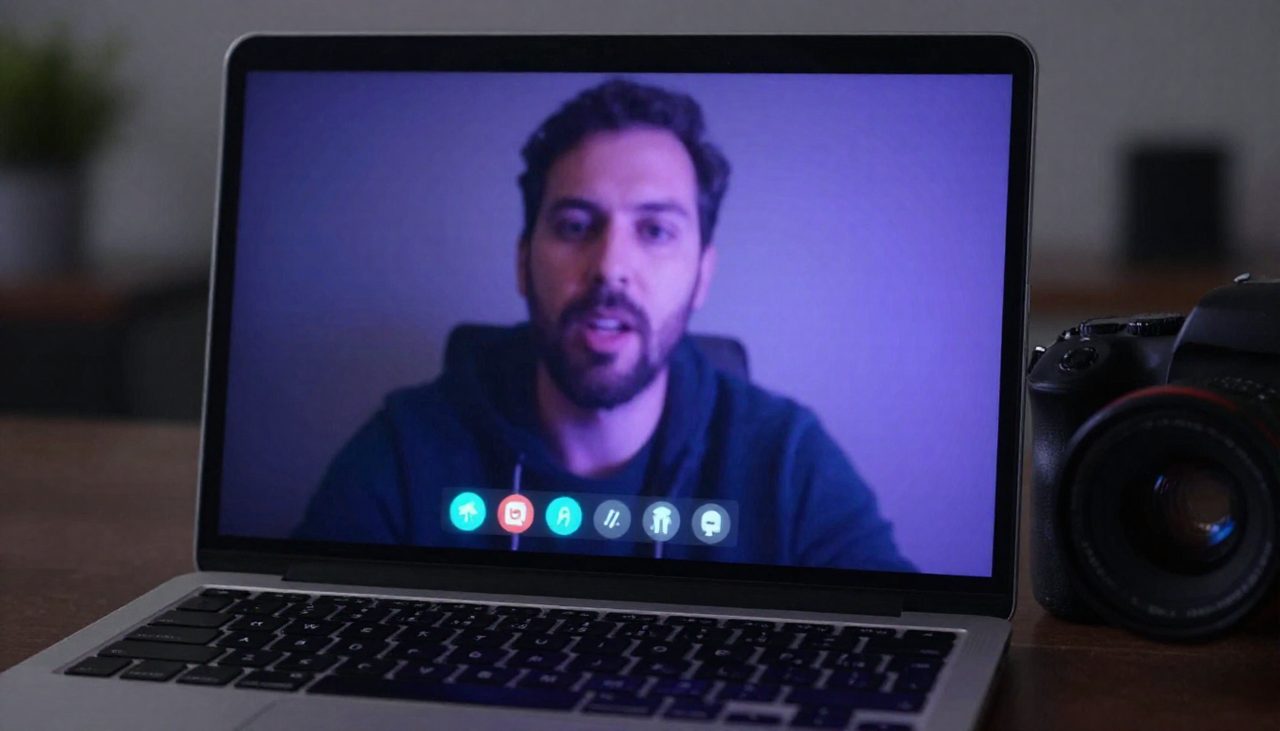
La lógica de 'ver para creer' en la verificación de identidad tambalea, pero el criterio lo definió el propio Tavus y la vista previa aún no está disponible para todos
Veamos los datos antes de hablar de "ver para creer": tras una llamada de un minuto con Griffin-Lite, el modelo en versión de investigación de Tavus, 26 de los 54 participantes creyeron que tenían enfrente a una persona real, cerca del 48%; en cambio, el sistema de la generación anterior, con el mismo procedimiento, solo engañó a 1 de 41 personas, una tasa de error del 2,4%.
Sobre esta base, Tavus define a Griffin como el primer modelo en superar el «test de Turing en video» en tiempo real, y ha creado una nueva categoría para ubicarlo: Human Interaction Model (modelo de interacción humana, HIM). Al cierre de esta edición, casi 17,36 millones de usuarios habían seguido el experimento en línea. Pero el «primer superado» sigue siendo, por ahora, la autodefensa de Tavus sobre sus propios resultados, el modelo aún no está disponible de forma general en vista previa, y no se puede descartar que sea una demo prometedora sin sustento.
El verdadero atractivo técnico de este lanzamiento está en el cambio de paradigma de interacción: del sistema en cascada al dúplex completo. Los sistemas en cascada habituales encadenan reconocimiento de voz, respuesta del modelo de lenguaje, síntesis de voz y animación del avatar digital como una línea de montaje: solo cuando el usuario termina su frase, el sistema la procesa. Griffin, en cambio, genera voz e imagen mientras recibe de forma continua el audio y el video del usuario. Su motor de modelado de conversación sostenida reevalúa el estado de la interacción en intervalos de menos de un segundo y, combinando la expresión facial, la mirada, el tono y las pausas de la otra persona, decide qué decir y cuándo intervenir, emitiendo señales de control de emoción, expresión y movimiento que el motor de generación audiovisual convierte en imagen y sonido continuos. Ante un mismo silencio, debe distinguir si la otra parte está pensando, ya terminó de hablar o espera que se le siga explicando: ese tipo de detalles fuera del lenguaje son justamente donde la IA suele delatarse en una conversación.
El alcance de la generación visual también se amplía. Según Tavus, Griffin puede generar en tiempo real toda la escena a partir de una sola imagen de referencia, incluyendo el rostro, los brazos y los dedos de la persona, además del movimiento de la silla, las sombras y los cambios del fondo; así, el personaje puede asentir, ajustar la mirada o cambiar de expresión durante la fase de escucha, sin esperar a hablar para moverse. Las demostraciones oficiales incluyen también un juego de imitación por instrucciones, la interacción con un cubo de Rubik y la observación de un usuario soldando una placa de circuitos. Cuando incluso la imagen de la cámara puede generarse en tiempo real, tomar la apertura de video como última garantía para confirmar una identidad exige replantear los presupuestos.
Etiquetas: Tavus · Griffin · Video Turing Test · Full-Duplex · Human Interaction Model · Digital Human
萬安算交所 AIXX · AIXX · Exchange verificado · Ir al mercado